[대기업 사례] AI 학습 데이터 계약, 모델이 쓰일 곳까지 내다보고 설계해야 하는 이유
2026. 10. 20
학습 데이터는 모델을 만드는 단계에서만 쓰이는 자산이라고 생각하기 쉽습니다. 하지만 학습이 끝난 모델은 제품에 들어가고, 서비스가 늘어날 때마다 더 넓은 곳에서 쓰여요. 그때마다 "이 데이터로 학습한 모델을 여기에도 써도 되나"라는 질문이 다시 나오면 계약을 새로 해야 합니다.
국내 대기업 한 곳이 비큐AI와 함께 풀어야 했던 문제가 바로 이것이었습니다.
과제: 많이 모으는 것보다 어디까지 쓸 수 있느냐
이 기업은 자체 한국어 AI 모델을 사전학습하기 위해 대규모 뉴스 코퍼스가 필요했습니다. 뉴스는 산업, 사회, 인물, 기업, 시간에 따라 변하는 이슈를 고루 담고 있어 언어 이해와 맥락 처리 능력을 키우는 데 좋은 데이터예요.
문제는 이 모델이 한 서비스에만 쓰이지 않는다는 점이었습니다. 학습한 모델과 AI 기능은 여러 제품과 서비스로 확장될 계획이었고, 그 기간도 한두 해가 아니었습니다. 더구나 뉴스는 개별 언론사의 저작물이라, 공급사와의 계약만으로는 원권리자의 허락 범위까지 확인되지 않아요.
그래서 다음 세 가지를 동시에 만족하는 구조가 필요했습니다.
- 사전학습에 충분한 규모의 한국어 뉴스 아카이브
- AI 모델 학습에 쓸 수 있는 권리
- 학습한 모델을 실제 제품과 서비스에 적용할 수 있는 사용 범위
솔루션: 데이터와 사용 범위를 한 번에 설계했습니다
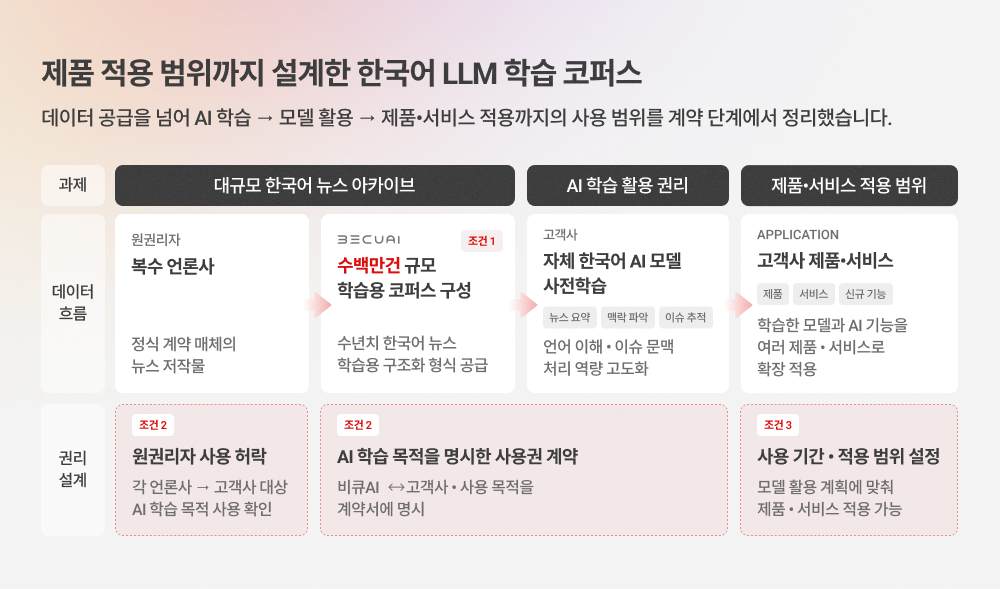
비큐AI는 복수 언론사의 수년치 기사를 수백만 건 규모의 학습용 코퍼스로 구성해, 바로 학습 파이프라인에 넣을 수 있는 구조화 형식으로 공급했습니다.
더 중요한 건 계약 설계였어요. 사용 목적을 AI 학습으로 명시하고, 사용 기간과 적용 범위는 고객사의 모델 활용 계획에 맞춰 정했습니다. 또한 원권리자인 각 언론사로부터 해당 고객사의 사용에 대한 허락을 별도로 확인해, 공급사 계약과 원권리자 허락이 어긋날 여지를 없앴습니다.
성과
고객사는 학습 단계부터 제품 적용 단계까지, 새 제품에 모델을 올릴 때마다 데이터 권리를 다시 협의하지 않아도 되는 근거를 계약 단계에서 확보했습니다. 데이터 확보와 활용 범위를 한 번에 정리한 셈이에요.
학습 데이터 계약 전에 확인할 다섯 가지
비슷한 모델을 준비하고 계신다면, 데이터 양보다 아래 항목을 먼저 점검해 보세요.
| 확인 항목 | 확인할 내용 |
|---|---|
| 사용 목적 | 사전학습, 파인튜닝, RAG 중 어떤 용도가 계약에 명시돼 있는가 |
| 사용 기간 | 모델을 얼마나 오래 운영하고 고도화할 계획인가 |
| 적용 범위 | 학습한 모델을 어떤 제품·서비스·시장에 적용할 것인가 |
| 원권리자 허락 | 개별 매체의 허락 범위가 공급 계약과 일치하는가 |
| 데이터 형식 | 별도 전처리 없이 학습 파이프라인에 넣을 수 있는가 |
AI 학습 데이터 계약은 모델 개발 시점이 아니라 제품이 실제로 쓰일 범위를 기준으로 설계해야 합니다.
RDPLINE은 필요한 데이터 규모와 활용 계획에 맞춰 라이선스 구조를 함께 설계해 드려요. 학습 데이터 범위부터 같이 정리해 보시겠어요?
.jpg)